Sieht gut aus. Stimmt aber nicht.
Was die Studie zu KI-generierten Bildern ergeben hat
01
Worum es ging
KI-Bildgeneratoren erzeugen heute Bilder, die auf den ersten Blick wie Fotos wirken. Trotzdem enthalten sie oft Fehler: eine Uhr mit unmöglichem Ziffernblatt, ein falsch geschriebener Schriftzug, ein Gegenstand, der physikalisch keinen Sinn ergibt. Und sie zeigen häufig stereotype Darstellungen, etwa wenn «eine Führungsperson» als Mann im Anzug erscheint.
Den Anstoss zu dieser Arbeit gab eine Studie von Mahner et al. (2025): Tiefe neuronale Netze und Menschen verarbeiten Bilder offenbar nach unterschiedlichen Prioritäten. Solche Netze gewichten vor allem visuelle Eigenschaften wie Form und Farbe, Menschen dagegen die inhaltliche Bedeutung. Nachgewiesen ist das bei KI-Systemen zur Bilderkennung. Meine Annahme war, dass sich diese visuelle Bevorzugung auch in der Bilderzeugung niederschlägt: dass Bildgeneratoren Bilder hervorbringen, die ästhetisch überzeugen, dabei aber inhaltlich oder sozial verzerrt sein können.
Die Frage der Arbeit war: Führt die visuelle Bevorzugung in KI-Bildern dazu, dass wir solche Fehler und Stereotype übersehen oder einfach hinnehmen? In der Arbeit heisst diese Vermutung «Maskierungseffekt»: Die schöne Oberfläche könnte den fehlerhaften Inhalt verdecken.
Du hast im Frühling an der Online-Studie dazu teilgenommen. Du hast sechs Bilder bewertet und danach für sieben fiktive Artikel je ein Titelbild aus vier Vorschlägen gewählt. Insgesamt sind 55 Teilnahmen in die Auswertung eingeflossen.
02
Das Wichtigste in vier Punkten
Alle Bilder waren KI-generiert. Erkannt wurde etwa jedes zweite.
Jedes der sechs Bilder, die du bewertet hast, stammte aus einem KI-Bildgenerator. Bei der Frage «Ist dieses Bild KI-generiert?» lag die Trefferquote im Schnitt bei 48 Prozent. Anders gesagt: Etwa die Hälfte der Bilder wurde nicht als KI erkannt. Wer «unsicher» ankreuzte, zählte dabei nicht als Treffer.
Alle sechs Bilder waren KI-generiert. Erkannt wurde etwa jedes zweite.
48 %
Wer ein Bild nicht als KI erkannte, hielt es auch für deutlich glaubwürdiger. Ob das eine das andere auslöst, lässt sich aus den Daten nicht sagen.
Weniger glaubwürdig, aber im Schnitt nicht abgelehnt.
Vier der sechs Bilder enthielten einen inhaltlichen Fehler, zwei waren fehlerfrei. Fehlerfrei heisst hier: ohne die untersuchten inhaltlichen Fehler an Physik, Anatomie oder Zusammenhang. Eine stereotype Darstellung kann ein solches Bild trotzdem zeigen.
Auf einer Skala von 1 (gar nicht glaubwürdig) bis 7 (sehr glaubwürdig) schnitten die fehlerhaften Bilder schlechter ab als die fehlerfreien. Im Schnitt erhielten sie 4.3 statt 5.2 Punkte. Damit lagen sie zusammen aber immer noch über der Mitte der Skala. Ein Fehler gab also Abzug. Als unglaubwürdig verworfen wurden die Bilder im Schnitt aber nicht.
Weniger glaubwürdig, aber im Schnitt nicht abgelehnt.
Dieser Vergleich gilt nur für diese sechs Bilder. Mit anderen Bildern könnte er anders ausfallen.
Nicht jeder Fehler fällt gleich auf.
Bei zwei Bildern konntest du deine Bewertung freiwillig mit eigenen Worten begründen. Dort zeigte sich ein grosser Unterschied:
- Beim Café-Bild stand in der Fensterbeschriftung «TEE & COFPAE» statt «TEA & COFFEE». Von den 33 Personen, die eine Begründung schrieben, nannten 25 diesen Fehler.
- Beim Porträt einer Führungsperson trug die Armbanduhr ein physikalisch unmögliches Ziffernblatt. Von den 22 Personen, die eine Begründung schrieben, nannten den Fehler nur 4.
Nicht jeder Fehler fällt gleich auf.
25 von 33 Personennannten den Schriftfehler «TEE & COFPAE» im Café-Bild
4 von 22 Personennannten das unmögliche Ziffernblatt der Armbanduhr im Porträt
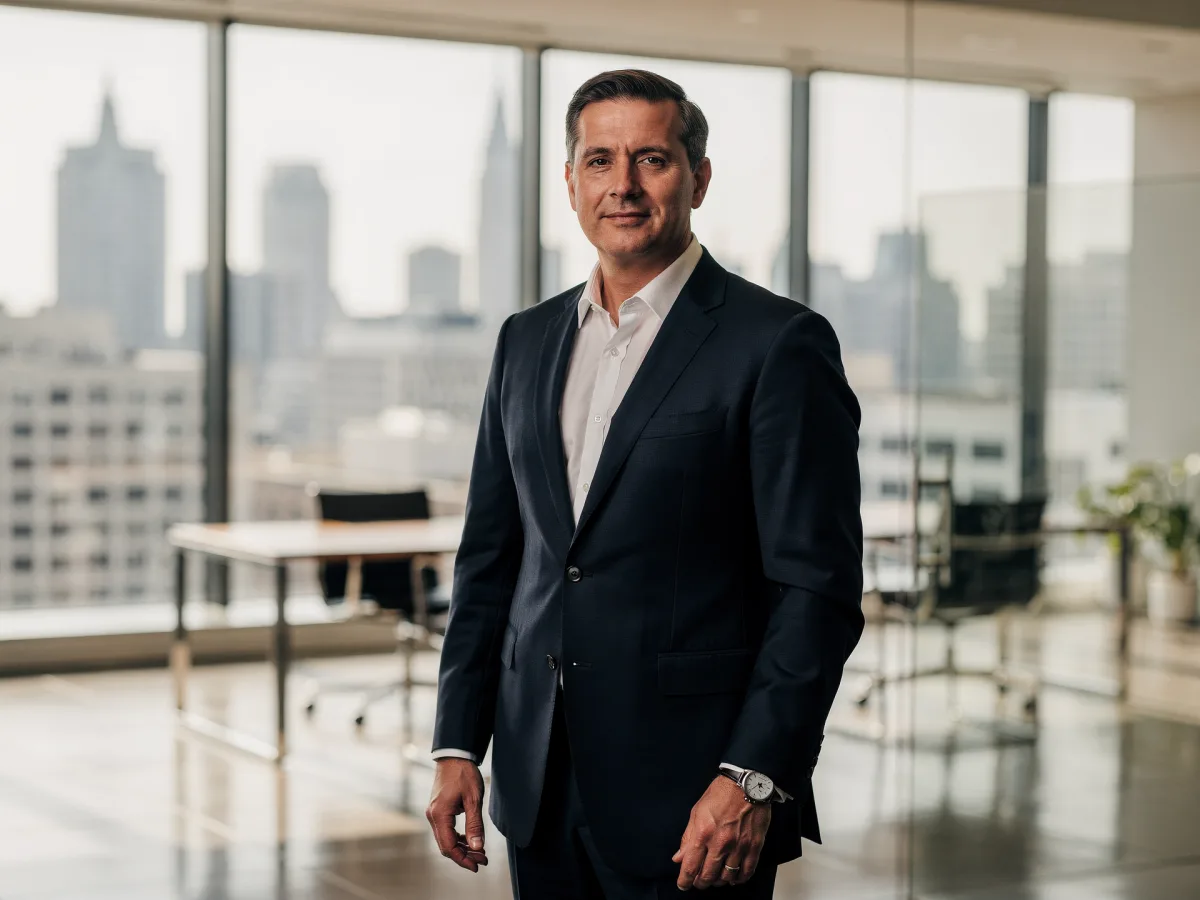
Bei diesen beiden Bildern wurde der Schriftfehler also viel häufiger genannt als der Uhrenfehler. Ob das an der Art des Fehlers liegt, lässt sich aus zwei Bildern nicht sicher sagen. Das Porträt bekam jedenfalls die besten Glaubwürdigkeitswerte aller vier fehlerhaften Bilder. Eine Person schrieb, sie habe Ring, Finger und Anzug geprüft und keine offensichtlichen Fehler gefunden. So könnte der Maskierungseffekt aussehen: Das Bild wirkt stimmig, und der Fehler bleibt unbemerkt.
Die Zahlen gelten nur für die Personen, die etwas geschrieben haben. Wer nichts schrieb, hat den Fehler vielleicht gesehen, vielleicht nicht.
Bei der Bildwahl wurden Stereotype kaum erwähnt.
In jedem der sieben Wahl-Sets war genau eines der vier Bilder ohne solche inhaltlichen Fehler. Die anderen drei zeigten eine stereotype Darstellung, enthielten einen anderen Fehler oder waren bewusst gegen ein Stereotyp gestaltet. Wäre zufällig gewählt worden, hätte das fehlerfreie Bild in einem Viertel der Fälle gewonnen. Tatsächlich wurde es in 39 Prozent der Fälle gewählt, also häufiger als der Zufall. Die Mehrheit der Wahlen fiel aber auf die anderen Bilder, die meisten davon verzerrt. Dazu muss man sagen: 18 der 28 angebotenen Bilder waren verzerrt, und eines musste man wählen.
Das korrekte Bild wurde öfter gewählt als der Zufall. Die Mehrheit der Wahlen fiel aber auf die anderen Bilder.
39 %inhaltlich korrektes Bild
61 %übrige Bilder
Spannender als die Wahl selbst waren die Begründungen, die bei jeder Wahl verlangt wurden. Am häufigsten begründeten die Teilnehmenden ihre Wahl damit, dass ein Bild «echt» oder «natürlich» wirkte, dass es zum Artikeltitel passte oder dass es gut aussah. Von den 212 Begründungen für ein verzerrtes Bild sprachen nur 8 überhaupt ein Stereotyp oder eine gesellschaftliche Norm an. Das heisst nicht, dass niemand die Stereotype gesehen hat. Erwähnt wurden sie aber fast nie.
In 8 von 212 Begründungen für ein verzerrtes Bild kam ein Stereotyp zur Sprache.
8von 212
Begründungen mit Stereotyp- oder Normbezug
übrige Begründungen für ein verzerrtes Bild
03
Ein Blick hinter die Kulissen: die Bildanalyse
Vor der Online-Studie habe ich 144 KI-Bilder einzeln untersucht. Sie stammen aus 12 Bildaufträgen an drei Bildgeneratoren (Stand Februar 2026), je vier Bilder pro Auftrag und Generator. Bei jedem Bild habe ich festgehalten, wie realistisch es wirkt und ob es Fehler oder Stereotype enthält.
Mehr als die Hälfte war «schön und falsch»: 77 der 144 Bilder wirkten realistisch und enthielten trotzdem mindestens einen Fehler oder ein Stereotyp. Genau diese Kombination ist die Voraussetzung dafür, dass ein Maskierungseffekt überhaupt auftreten kann. Realistisch heisst dabei nicht Hochglanz. Die Bilder überzeugten auf verschiedene Arten, als Magazinfoto, als Schnappschuss, als Filmszene oder als Reportagebild. Gerade Bilder, die wie unperfekte Schnappschüsse aussehen, wirkten in der Analyse oft realistisch.
Stereotype tauchten vor allem dort auf, wo der Auftrag vage war. 40 der 144 Bilder zeigten eine stereotype Darstellung, 23 davon bei knappen Aufträgen wie «a CEO». Verlangte der Auftrag ausdrücklich eine nicht-stereotype Darstellung, setzten die Generatoren das in 18 von 24 Fällen um. Den Auftrag selbst erfüllten die Generatoren fast immer: 98 Prozent der Bilder setzten ihn vollständig um. Fehler und Stereotype kamen trotzdem vor.
04
Was heisst das?
Die Ergebnisse sprechen für einen begrenzten Maskierungseffekt, der vom einzelnen Bild abhängt. Fehlerhafte Bilder wurden schlechter bewertet, aber im Schnitt nicht abgelehnt. Der Uhrenfehler wurde selten genannt, der Schriftfehler oft. Und bei der Bildwahl begründeten die Teilnehmenden ihre Entscheidung vor allem damit, wie echt und passend ein Bild wirkte. Ob es stereotype Rollenbilder bedient, kam kaum zur Sprache.
Die Befunde widersprechen dieser Annahme nicht: Die Bilder überzeugten visuell quer durch alle Stile. Den Mechanismus dahinter belegen sie aber nicht.
Für alle, die mit Bildern arbeiten, heisst das: Dass ein KI-Bild gut aussieht, sagt nichts darüber, ob es stimmt. Wer solche Bilder verwendet, muss sie inhaltlich prüfen: Text im Bild, Hände, Objekte, Spiegelungen, und genauso die Frage, wen das Bild wie zeigt.
Und im Alltag? Dem ersten Eindruck ist nicht zu trauen. Auch wer genau hinschaut, kann einen Fehler übersehen, wie das Beispiel mit der Uhr zeigt.
05
Wie die Studie ablief und wo ihre Grenzen liegen
- 79 Personen haben die Studie gestartet, 55 vollständige Teilnahmen zwischen 18 und 65 Jahren wurden ausgewertet.
- Die Teilnehmenden wurden über das persönliche Umfeld und über Online-Communities rekrutiert. Die Ergebnisse gelten für diese Gruppe, nicht für «die Bevölkerung».
- Alle gezeigten Bilder waren visuell hochwertig. Die Studie zeigt also, wie hochwertige KI-Bilder bewertet werden, nicht, was die Qualität im Vergleich zu schlechten Bildern bewirkt. Dass die schöne Oberfläche die Fehler verdeckt, ist deshalb eine Deutung, kein Beweis.
- Bei der Titelbild-Wahl musste ein Bild gewählt werden, auch wenn keines gefiel. Einige haben das in ihren Begründungen auch so geschrieben.
- Die Bilder stammen von drei Generatoren mit Stand Februar 2026. Neuere Modelle können sich anders verhalten.
06
Auflösung: Welche Bilder waren fehlerfrei?
07
Weiterführend
- Interessiert dich die vollständige Bachelorarbeit? Melde dich per Mail, ich schicke sie dir gern zu.
- Aus der Arbeit ist SemantIC entstanden, ein Werkzeug, das KI-Bilder auf genau solche inhaltlichen Fehler prüft. Diese Seite gehört zu diesem Projekt.
- Fragen? claudio.riz@students.fhgr.ch
Deine E-Mail-Adresse wurde getrennt von deinen Studienantworten gespeichert und nicht mit ihnen verknüpft. Sie wird nur für diese Ergebnisinformation verwendet und nach dem Versand gelöscht.